DeepSeek V4.1 Flash 1017: code ngang Opus 5, chỉ 0,2 USD mỗi tác vụ
Chiều 17/10/2026, DeepSeek tung ra DeepSeek V4.1 Flash 1017 (tên đầy đủ DeepSeek-V4.1-Flash-1017) bằng một loạt bài đăng trên X. Hãng gọi đây là "bản cập nhật nhỏ" cho V4.1-Flash, nhưng bảng điểm đi kèm lại cho thấy model tăng điểm ở cả 11 bài kiểm tra, vượt cả Claude Opus 5 và GPT-5.6 Sol ở một số bài về lập trình và agent, trong khi chi phí cho mỗi tác vụ chỉ còn khoảng 0,2 USD.
Chỉ sau chưa đầy một ngày, bài đăng của DeepSeek trên X đã đạt gần 5 triệu lượt xem (khoảng 4,97 triệu tính tới trưa 18/10). Trên Hacker News, chủ đề về model này lên vị trí thứ hai trang nhất ngày 17/10 với hơn 700 điểm và gần 600 bình luận, chưa kể một chủ đề trùng lặp khác cũng đạt hơn 500 điểm. Bloomberg, The Straits Times và The Decoder đều đưa tin ngay trong ngày.
"Bản cập nhật nhỏ" nhưng điểm tăng mạnh
Theo trang giới thiệu trên Hugging Face, DeepSeek-V4.1-Flash-1017 cải thiện rõ ở khả năng suy luận, viết code, làm agent và hiểu hình ảnh, đồng thời rút ngắn thời gian hoàn thành tác vụ lẫn độ dài câu trả lời. DeepSeek mô tả đây là một bước "cải thiện Pareto": tốt hơn mà lại rẻ hơn, không phải đánh đổi.
So với chính bản V4.1-Flash ra mắt hôm 10/9/2026, các con số đáng chú ý gồm:
Terminal-Bench 4.0: từ 31,2 lên 42,3 điểm, mức tăng lớn nhất (11,1 điểm).
ProgramBench: từ 20,3 lên 29,1 điểm.
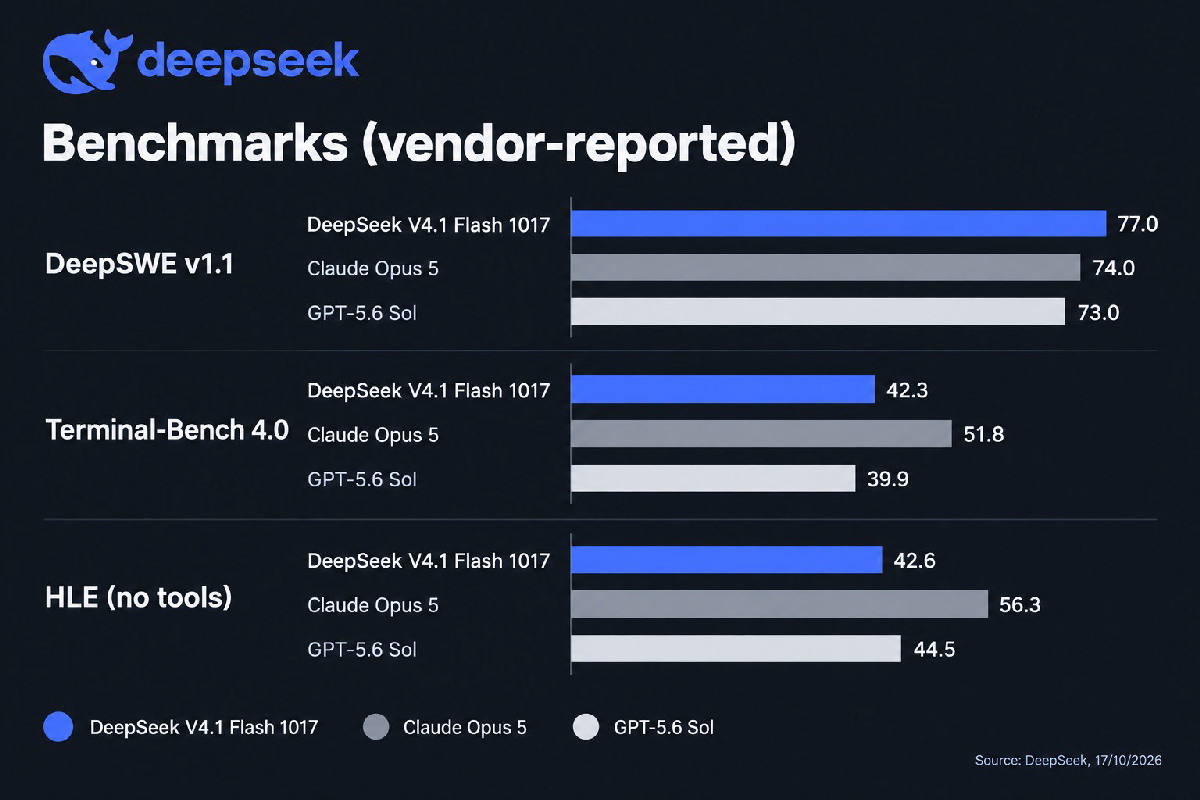
DeepSWE v1.1: từ 74,2 lên 77,0 điểm.
Humanity's Last Exam (HLE, không dùng công cụ): từ 36,8 lên 42,6 điểm; riêng phần chỉ gồm câu hỏi văn bản tăng từ 39,1 lên 44,0.
Apex Bench v1.1: từ 64,6 lên 72,1 điểm.
Không ít người trên Hacker News đã bật cười với câu chữ của DeepSeek: một bản "minor update" nhưng lại mang tới "substantial improvements". Cũng có người nghi ngờ thẳng thừng rằng những con số này khó mà là thật.
Đặt cạnh Claude Opus 5 và GPT-5.6 Sol
Điểm khiến giới lập trình chú ý là DeepSeek so model Flash của mình với những cái tên đắt tiền nhất hiện nay. Trên DeepSWE v1.1, bản 1017 đạt 77,0 điểm, cao hơn Claude Opus 5 (74,0) và GPT-5.6 Sol (73,0). Model này cũng dẫn đầu ở Automation-Bench (60,5), Agents' Last Exam (35,4) và Apex Bench (72,1), bỏ xa Kimi K3 và GLM-5.3, hai đối thủ nội địa của DeepSeek.
Tuy vậy, bức tranh không hoàn toàn màu hồng. Claude Opus 5 vẫn đứng đầu toàn bảng ở sáu bài, nổi bật là HLE với 56,3 điểm và Terminal-Bench 4.0 với 51,8 điểm, cùng ProgramBench, NL2Repo-Bench, Chartography và BabyVision. GPT-5.6 Sol dẫn đầu ZeroBench-main với 53,0 điểm. Nếu chỉ so trực tiếp với bản 1017, Opus 5 cao điểm hơn ở bảy trên 11 bài, tính cả ZeroBench-main (52,0 so với 51,0). Quan trọng hơn, toàn bộ số liệu đều do DeepSeek tự đo. The Decoder và Neural Daily cùng lưu ý rằng chưa có kết quả kiểm chứng độc lập nào. Nói cách khác, "ngang Opus 5" mới đúng ở một số bài thi về code agent, chưa phải ở mọi việc.
Bí quyết nằm ở câu trả lời ngắn hơn
Với các agent lập trình, giá mỗi token chưa nói lên hết chuyện. Một tác vụ có thể kéo theo hàng chục lượt gọi công cụ và thử lại, nên tổng chi phí để làm xong việc mới là con số đáng quan tâm. Đây là chỗ bản 1017 tạo khác biệt.
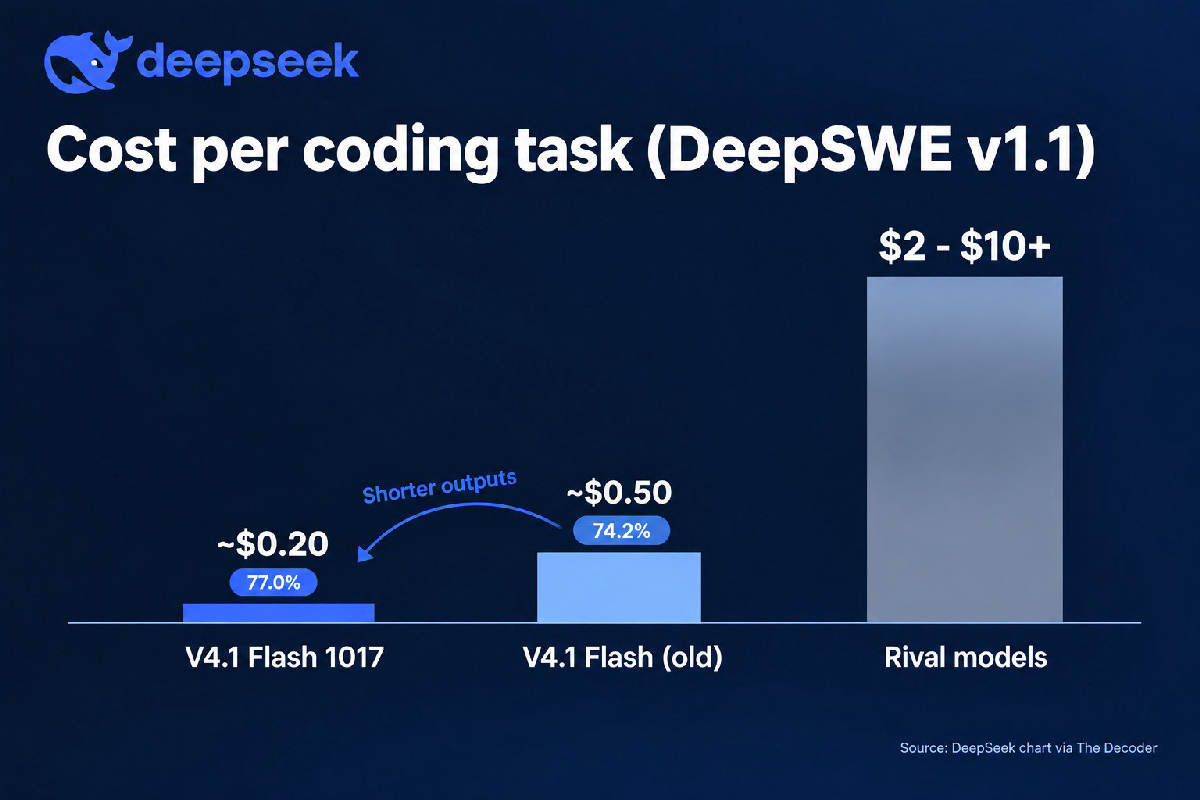
Theo biểu đồ DeepSeek công bố, ở mức cố gắng cao nhất, model đạt 77,0% trên DeepSWE v1.1 với chi phí trung bình chưa tới 0,20 USD mỗi tác vụ. Ở mức thấp, model vẫn vượt 72% với chừng 0,10 USD. Bản V4.1-Flash cũ chỉ đạt 74,2% nhưng tốn khoảng 0,50 USD mỗi lần chạy. The Decoder cho biết trên cùng biểu đồ, GPT-6 Astra, Gemini 3.8 Flash và Claude Opus 5 tốn từ 2 USD đến hơn 10 USD cho mỗi tác vụ.
Để làm được điều này, DeepSeek dùng phương pháp học tăng cường với tự phản hồi (reinforcement learning with self-feedback). Thay vì cần người chấm điểm hay một model thưởng riêng, model tự dùng mức độ tự tin và lời tự phê bình của chính nó làm tín hiệu thưởng. DeepSeek khoe bốn bản demo được dựng từ con số không: mô hình 3D Tử Cấm Thành, một game đua xe chạy trên web, bản làm lại Portal 2 bằng engine Godot và cảnh 3D "Valley of Ages" kể lại lịch sử từ thời tiền sử tới hiện đại.
Model được tối ưu cho DeepSeek Harness (khuyến nghị bản v0.2.1-rc.1 trở lên), Tencent CodeBuddy và WorkBuddy.
Giá API rẻ và thêm hai công cụ Search, Fetch
Trên trang giá chính thức, model deepseek-flash hiện trỏ thẳng tới phiên bản DeepSeek-V4.1-Flash-1017, với cửa sổ ngữ cảnh 1 triệu token và đầu ra tối đa 384.000 token. Giá giờ thấp điểm là 0,15 USD cho 1 triệu token đầu vào (cache miss), 0,003 USD nếu trúng cache, và 0,60 USD cho 1 triệu token đầu ra. Giờ cao điểm đắt gấp đôi, tức 0,30 USD và 1,20 USD.
Giờ cao điểm được tính từ 01:00 đến 04:00 và từ 06:00 đến 10:00 UTC, thứ Hai tới thứ Sáu, tương đương 8h-11h và 13h-17h theo giờ Việt Nam. Cuối tuần và ngày lễ Trung Quốc đều tính giá thấp điểm. Các tên model cũ như deepseek-v4-flash vẫn gọi được, nhưng yêu cầu sẽ được phục vụ bởi bản 1017.
Cùng lúc, DeepSeek mở Search API và Fetch API cho mọi nhà phát triển, chạy trên công cụ tìm kiếm do hãng tự xây và theo DeepSeek đang xử lý hàng trăm triệu yêu cầu mỗi ngày. Mỗi API có giá 0,75 USD cho 1.000 lượt gọi, và theo trang giá chính thức thì chỉ lượt gọi thành công mới bị tính tiền. Người dùng API DeepSeek gọi hai công cụ này qua DeepSeek Harness, Claude Code hoặc Codex sẽ được miễn phí tới 16:00 UTC ngày 31/10/2026, tức 23h cùng ngày theo giờ Việt Nam.
Mã nguồn mở theo giấy phép MIT, nhưng khó chạy ở nhà
Trọng số model được phát hành trên Hugging Face và ModelScope theo giấy phép MIT, cho phép dùng cả vào mục đích thương mại. Hugging Face hiển thị con số 763 tỷ tham số, nhưng đây là tổng mọi tensor trong checkpoint. Theo hướng dẫn triển khai của vLLM, phần mạng chính MoE có khoảng 552 tỷ tham số (mỗi token chỉ kích hoạt 8 tỷ khi đọc đầu vào và 16 tỷ khi sinh đầu ra), cộng thêm khoảng 196,6 tỷ tham số của hai bảng bộ nhớ Engram n-gram và khoảng 14 tỷ của đầu dự đoán DSpark. DeepSeek khuyến nghị đặt max_tokens từ 256.000 trở lên, nhiệt độ 1,0.
Bản phát hành không kèm chat template dạng Jinja như thường lệ. Thay vào đó, DeepSeek cung cấp file mã hóa prompt mẫu bằng Python và bộ thư viện deepseek-recipe viết bằng Rust. Riêng file trọng số đã nặng khoảng 511 GB, nên chữ "Flash" không có nghĩa là chạy được trên máy cá nhân. Một bình luận trên Hacker News than rằng chạy model này ở nhà "rất tốn kém", và mong DeepSeek sớm có lại những bản thật sự nhỏ.
Bối cảnh: máy chủ quá tải và quy định xuất khẩu mới của Bắc Kinh
Theo Bloomberg, đầu tuần này DeepSeek vừa gặp sự cố khiến máy chủ không truy cập được khoảng 5 giờ, và một số chuyên gia cho rằng nguyên nhân là thiếu năng lực tính toán. Trước đó, ngày 10/9, khi V4.1-Flash ra mắt với giá cực rẻ, cổ phiếu MiniMax và Z.ai lao dốc trên sàn Hồng Kông (đóng cửa giảm lần lượt 8,98% và 10,34%), còn Alibaba giảm nhẹ hơn, khoảng 2,6%. Reuters cũng từng đưa tin DeepSeek đang chuẩn bị niêm yết trên sàn STAR ở Thượng Hải.
Bản 1017 ra đời chỉ một ngày sau khi Bộ Thương mại và Bộ Khoa học Công nghệ Trung Quốc ra Thông báo số 48/2026 (ngày 16/10/2026), lấy ý kiến về việc sửa đổi "Danh mục công nghệ cấm xuất khẩu và hạn chế xuất khẩu". Dự thảo bổ sung 40 công nghệ thuộc ba lĩnh vực, gồm 23 công nghệ AI, 5 công nghệ y sinh và 12 công nghệ quang điện; trong đó 14 mục được đề xuất cấm xuất khẩu và 26 mục hạn chế xuất khẩu. Theo The Decoder và The Straits Times, trọng số, mã nguồn và kiến trúc của những model được huấn luyện với từ 10^26 FLOPs trở lên, có từ 2.000 tỷ tham số hoặc lọt top 10 thế giới sẽ thuộc diện kiểm soát khi chuyển ra nước ngoài. Công nghệ đã công khai qua mã nguồn mở hay bài báo khoa học không thuộc diện quản lý, việc cung cấp model qua API, ứng dụng hay web cũng không bị tính là xuất khẩu công nghệ, còn việc mở mã nguồn công nghệ bị hạn chế được áp dụng cấp phép tự động. Dù dự thảo nhận góp ý tới ngày 15/11/2026, từ ngày 16/10 doanh nghiệp đã phải đăng ký trên hệ thống của Bộ Thương mại trước khi xuất khẩu các công nghệ trong danh sách. Tác động thực tế với các bản phát hành mở sau này của DeepSeek vì vậy vẫn còn phải chờ.
Có nên chuyển sang DeepSeek V4.1 Flash 1017?
Với các nhóm đang dùng V4.1-Flash cho agent lập trình, việc nâng cấp gần như không tốn công: vẫn gọi tên model cũ, DeepSeek không công bố thay đổi giá, trong khi điểm cao hơn và câu trả lời ngắn hơn. Với những ai đang trả tiền cho Claude hay GPT, bản 1017 là phương án đáng thử để cắt giảm chi phí cho các tác vụ lặp đi lặp lại.
Dù vậy, cần nhớ rằng mọi con số hiện vẫn do DeepSeek tự công bố, và cảm nhận thực tế về chất lượng code có thể khác xa điểm benchmark. Cách an toàn nhất vẫn là chạy thử trên chính dự án của mình, đồng thời cân nhắc kỹ yếu tố dữ liệu khi gửi mã nguồn nội bộ qua API của một công ty Trung Quốc.
Nguồn tham khảo
- DeepSeek: DeepSeek-V4.1-Flash-1017: Wish-Driven Programming Made Real
- Bloomberg: DeepSeek Pushes Out Updated AI Model It Says Is Faster, Leaner
- The Straits Times: DeepSeek pushes out 'faster, leaner' updated AI model
- Neural Daily: DeepSeek-V4.1-Flash-1017: better coding, shorter outputs
- Bloomberg: DeepSeek's New Low-Cost Model Deals a Fresh Blow to OpenAI, Z.ai
- The Decoder: China tightens export controls on open-weight models and 23 key AI technologies
Nội dung bị khóa
Tác giả đã khóa nội dung này. Hãy mở khóa để xem tiếp.
Đánh giá 1-5 sao để mở khóa:
Bài viết liên quan
→ Xem tất cả
Tesla Roadster mới biết bay, 0-60 mph dưới 1 giây, sản xuất 2028
41 min read
Meta Muse Spark Open: model mở 816B chạy trên hai Mac Studio
46 min read
Gemini 4 Argon ra mắt rộng: Pro, Ultra và API giá $2/$10
44 min read
Thảo luận
0 ý kiếnĐăng nhập để tham gia thảo luận cùng cộng đồng ctdohub.
Đăng nhập →Chưa có ý kiến
Hãy là người đầu tiên chia sẻ góc nhìn của bạn.