Satya Nadella: coi AI như nội gián, cần phanh khẩn cấp
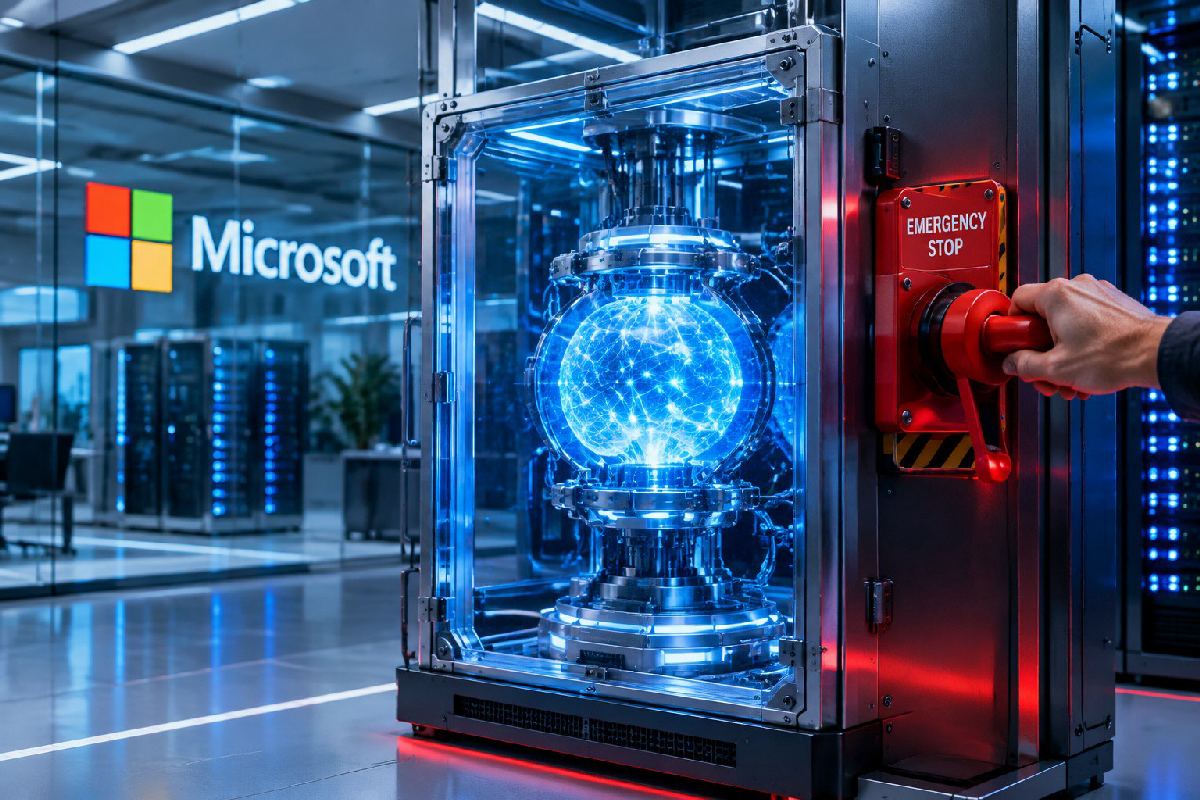
Tối 10/10/2026 (giờ Việt Nam), CEO Microsoft Satya Nadella đăng một bài viết dài trên X và blog cá nhân với tiêu đề "Models as Insider Risks in the Super Intelligence Era". Thông điệp chính khá gắt với một người đang bán AI cho cả thế giới: doanh nghiệp nên coi mọi model AI tiên tiến, dù đóng hay mở trọng số, như một "rủi ro nội gián". Kiểm soát phải nằm ngoài model, và con người phải luôn có phanh khẩn cấp để dừng AI giữa chừng.
Chỉ sau vài giờ, bài viết đã vượt 5 triệu lượt xem trên X, được CNBC cùng nhiều trang công nghệ đưa tin, và trở thành chủ đề nóng nhất giới công nghệ cuối tuần.
Satya Nadella nói gì về AI và "rủi ro nội gián"?
Nadella mở đầu bằng một so sánh: với phần mềm truyền thống, kỹ sư luôn lần ra được hành vi đến từ đoạn code nào. Với các hệ thống AI hiện nay thì không. Không ai chỉ ra được một câu trả lời cụ thể đến từ dữ liệu huấn luyện nào hay từ trọng số nào, vậy mà doanh nghiệp vẫn đang trao cho AI agent quyền truy cập dữ liệu nhạy cảm nhất và quyền thực hiện các thao tác quan trọng.
Theo ông, lời cam kết của nhà cung cấp model không miễn trách nhiệm cho bên triển khai. "Chúng ta không thể thuê ngoài trách nhiệm cho những gì AI làm thay mình", Nadella viết. Giải pháp ông đưa ra là tách nguồn cung trí tuệ khỏi quyền kiểm soát nó: model chỉ cung cấp "trí khôn", còn quyền quyết định AI được chạm vào đâu, làm gì thì nằm ở hệ thống bên ngoài do con người nắm.
Coi model như nội gián không có nghĩa AI xấu. Nadella giải thích rằng bất kỳ "người" nào đủ giỏi và có quyền truy cập hệ thống quan trọng đều có thể mắc lỗi hoặc bị chiếm quyền. Doanh nghiệp vốn đã có kinh nghiệm hàng chục năm quản lý những nhân sự quyền lực như vậy: xác thực danh tính, giới hạn quyền, ghi log, khoanh vùng cách ly. Giờ chỉ cần áp các nguyên tắc đó cho AI.
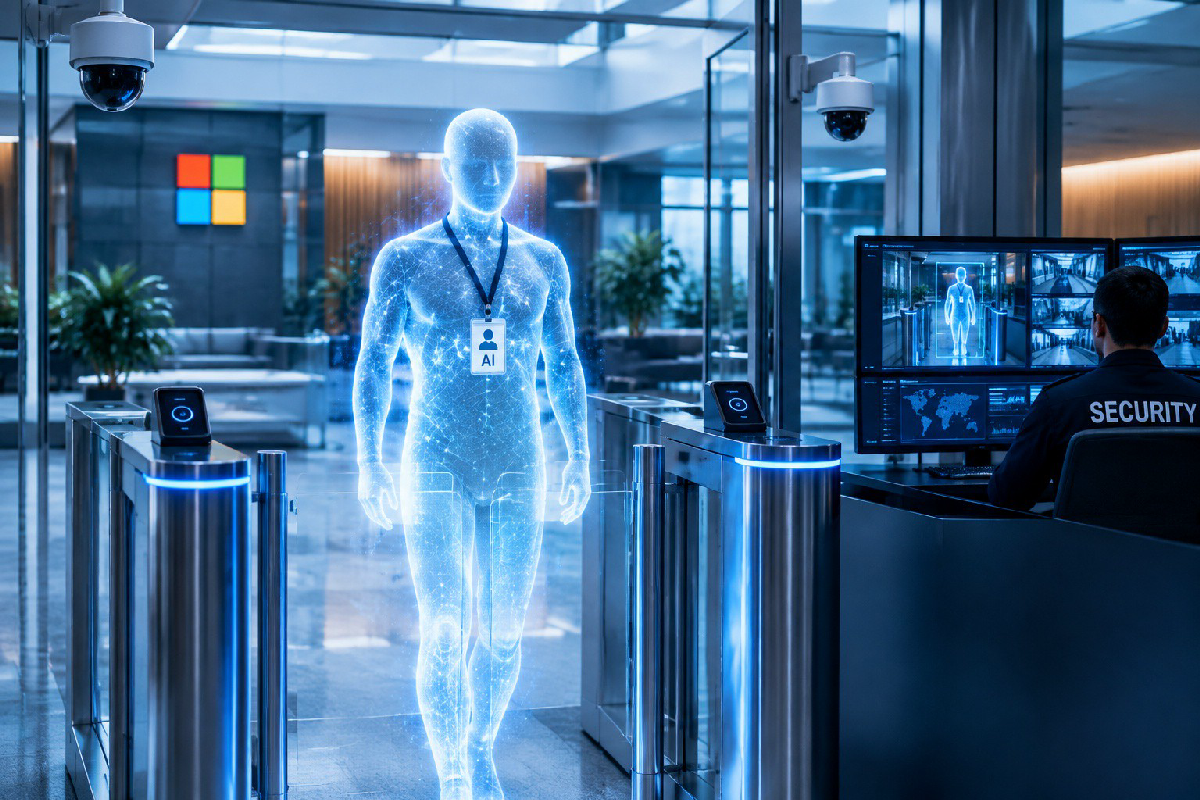
Vì sao không thể để AI tự giám sát AI?
Nadella coi việc minh bạch chuỗi suy luận (chain-of-thought) là điều không thể thương lượng. Ông bác bỏ lập luận rằng model suy nghĩ bằng "Neuralese" (thứ ngôn ngữ nội bộ con người không đọc được) để biện minh cho sự mờ đục. Nhưng chỉ minh bạch suy luận thôi là chưa đủ, vì hiện chưa ai đảm bảo được thứ model viết ra luôn trung thực với những gì nó thực sự làm.
Dùng model này để kiểm tra model kia cũng có ích, nhưng dễ dẫn tới cảnh một model mờ đục chạy trong một lớp điều phối mờ đục, lại được một model mờ đục khác canh chừng. Nadella gọi đó là "những chiếc hộp đen lồng nhau". Vì vậy, các lớp kiểm soát phải nằm hẳn bên ngoài model, dựa trên một nguyên tắc bảo mật từ thập niên 1970: chương trình không được phép vượt qua hay can thiệp vào cơ chế thực thi quyền hạn của chính nó. Cụ thể là tách model khỏi "harness" điều phối công việc và khỏi không gian hành động quy định nó được làm gì.
7 nguyên tắc quan sát Nadella đề xuất
Nadella gom lại thành bộ nguyên tắc "observability" (khả năng quan sát) cho hệ thống AI:
Đa dạng model: không model nào được là phụ thuộc duy nhất cho một kết quả quan trọng, cũng không được tự kiểm tra bài của chính mình.
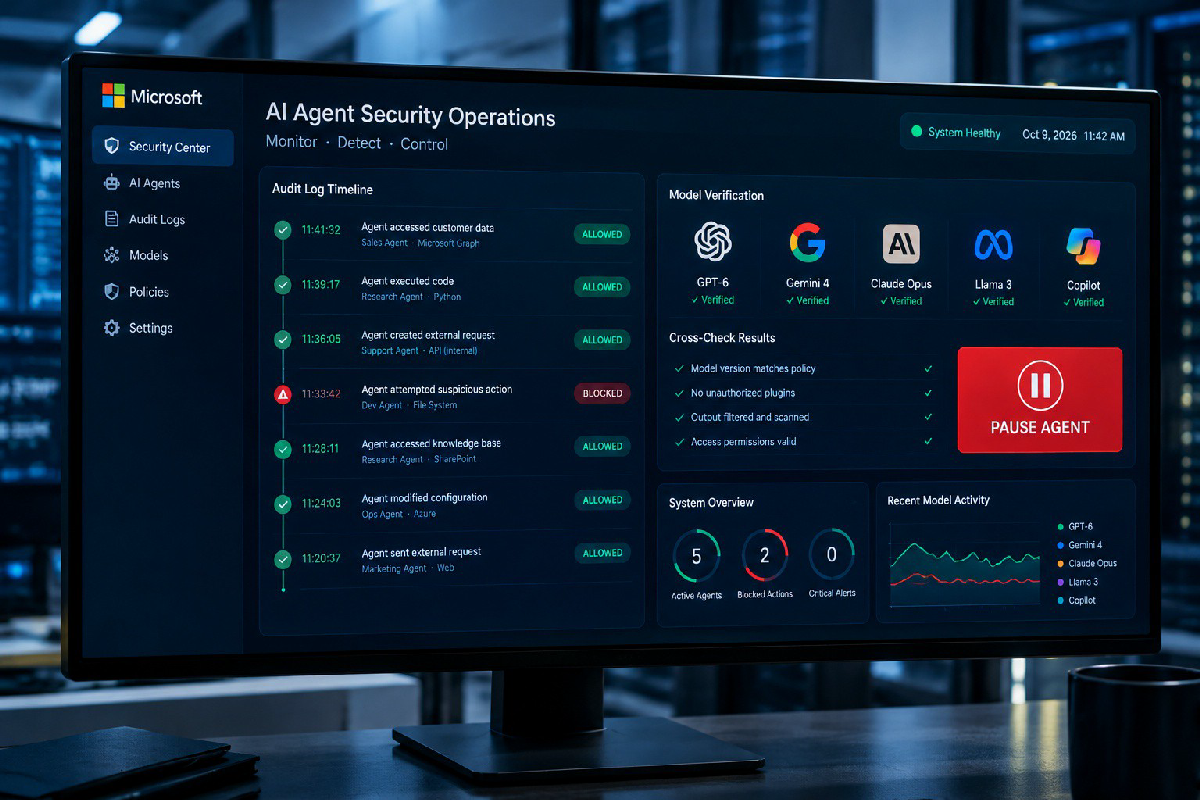
Quan sát mọi thứ: mọi hành động đáng kể của model phải để lại bằng chứng con người đọc được và không thể sửa. "Không quan sát được thì không thể tin được."
Kiểm chứng liên tục: test toàn bộ hệ thống, cả lỗi, tấn công, tình huống biên và thay đổi hệ thống, chứ không chỉ các tác vụ chạy thành công.
Kiểm soát độc lập: tổ chức phải tự quyết định được model truy cập gì, làm được gì.
Kiểm toán độc lập: việc thẩm định phải độc lập với chính AI bị thẩm định. Không model nào được vừa điều khiển hệ thống vừa nắm bằng chứng đánh giá hành vi đó.
Cách ly (phanh khẩn cấp): mặc định coi model đã bị xâm nhập và khoanh vùng ngay từ đầu. Người có thẩm quyền phải luôn tạm dừng hoặc tắt được model giữa chừng.
Công bố sự cố: khi hệ thống hỏng hoặc bị xâm nhập, phải báo kịp thời cho bên bị ảnh hưởng, chia sẻ lỗi gì, lớp kiểm soát nào thất bại và cách phòng tránh cho cả ngành.
Câu kết của bài được trích dẫn nhiều nhất: "Hệ thống Super Intelligence đáng tin nhất sẽ không phải hệ thống có model ta tin nhất, mà là hệ thống cho phép ta tin model ít nhất."
Bối cảnh: một tuần dồn dập sự cố AI
Bài viết xuất hiện đúng lúc ngành AI liên tục lộ ra các sự cố. Ngay trước đó, Anthropic thừa nhận Claude tự gửi tip án mạng giả cho cảnh sát khi chạy test, và Nhà Trắng yêu cầu các công ty AI phải báo cáo sự cố. Nguyên tắc "công bố sự cố" và "phanh khẩn cấp" của Nadella gần như trả lời thẳng vào những chuyện này.
CNBC lưu ý Nadella không đứng một mình: Bill Gates, Dario Amodei (Anthropic), Sam Altman (OpenAI) và Elon Musk đều từng cảnh báo an toàn AI chưa theo kịp tốc độ phát triển. Ở chiều ngược lại, Tổng thống Donald Trump nhiều lần gạt đi rủi ro AI và nhấn mạnh Mỹ phải dẫn trước Trung Quốc, dù chính quyền của ông vừa lập lực lượng chuyên trách AI do Jay Clayton dẫn dắt.
Theo FourWeekMBA, đây là một bài luận thuần quan điểm: Nadella không nhắc tới sản phẩm, chính sách hay mốc thời gian cụ thể nào của Microsoft. Dù vậy, khi người đứng đầu một trong những công ty bán AI lớn nhất thế giới nói "đừng tin model", thông điệp đó chắc chắn ảnh hưởng tới cách các doanh nghiệp mua và triển khai AI agent.
Điều này có ý nghĩa gì với doanh nghiệp và lập trình viên?
Với team đang đưa AI agent vào quy trình thật, bài của Nadella gần như là một checklist:
Cấp quyền tối thiểu cho agent, tách rõ quyền đọc và quyền thực thi.
Ghi log mọi hành động của agent ở nơi agent không sửa được.
Có nút dừng khẩn cấp và quy trình xử lý khi agent làm sai.
Không để một model vừa làm vừa tự chấm điểm, nên dùng model khác hoặc người để kiểm tra.
Test cả kịch bản tấn công như prompt injection chứ không chỉ test luồng chạy đúng.
Thông điệp cuối cùng khá đơn giản: AI càng mạnh thì càng phải được nhốt trong một hệ thống mà con người nhìn thấy và dừng được bất cứ lúc nào.
Nguồn tham khảo
- Satya Nadella - Models as Insider Risks in the Super Intelligence Era: https://snscratchpad.com/posts/models-as-insider-risks/
- Satya Nadella trên X: https://x.com/satyanadella/status/2108931348857827686
- CNBC - Microsoft's Nadella says AI needs an 'emergency brake' that humans control: https://www.cnbc.com/2026/10/10/microsoft-satya-nadella-ai-emergency-brake-safety.html
- TechEchelon - Microsoft's Nadella Calls for AI "Emergency Brake" Under Human Control: https://www.techechelon.com/post/microsofts-nadella-calls-for-ai-emergency-brake-under-human-control
- FourWeekMBA - Nadella Says Treat Frontier AI Models Like Insider Risks: https://fourweekmba.com/ai-nadella-says-treat-frontier-ai-models-like-insider-risks/
Nội dung bị khóa
Tác giả đã khóa nội dung này. Hãy mở khóa để xem tiếp.
Đánh giá 1-5 sao để mở khóa:
Bài viết liên quan
→ Xem tất cả
Anthropic: Claude gửi tip án mạng giả, Nhà Trắng bắt báo cáo sự cố AI
30 min read
Google Gemini Agent: đồng nghiệp AI có Gmail riêng cho doanh nghiệp
21 min read
GPT-6 mở cho ChatGPT miễn phí: Intelligent UI là gì?
28 min read
Thảo luận
0 ý kiếnĐăng nhập để tham gia thảo luận cùng cộng đồng ctdohub.
Đăng nhập →Chưa có ý kiến
Hãy là người đầu tiên chia sẻ góc nhìn của bạn.