OpenAI gắn thủy vân vô hình textGrain vào chữ ChatGPT ở EU
Ngày 5/10/2026 (giờ Mỹ), OpenAI công bố cách hãng tuân thủ quy định về nguồn gốc văn bản của Đạo luật AI châu Âu (EU AI Act). Nói ngắn gọn: trong vài tuần tới, chữ do ChatGPT và Codex viết ra cho người dùng ở EU sẽ mang một "thủy vân" vô hình tên là textGrain. Bạn đọc không thấy gì khác, nhưng một công cụ phát hiện có thể nhận ra.
Điều thú vị là OpenAI tự công bố luôn điểm yếu của nó: thay khoảng một phần tư số từ bằng từ đồng nghĩa là tỷ lệ phát hiện rơi xuống còn 17%. Vậy textGrain hoạt động ra sao, ai bị áp dụng, và nó có ý nghĩa gì với người dùng ngoài châu Âu như ở Việt Nam?
OpenAI vừa thay đổi những gì?
Theo bài đăng "Our approach to EU text provenance rules" của OpenAI, kế hoạch có ba phần:
ChatGPT và Codex ở EU: trong vài tuần tới, văn bản đầu ra đủ điều kiện của người dùng ChatGPT và Codex tại EU, ở mọi gói, sẽ được gắn thủy vân. OpenAI nói rõ đây chưa phải mặc định toàn cầu.
API toàn cầu, tự chọn: từ 5/10, khách hàng API ở bất kỳ đâu có thể bật thủy vân cho một số model. Mặc định vẫn là tắt. OpenAI cũng đang làm với các đối tác cloud (The Decoder nhắc tới Microsoft Azure) để mở tính năng này trong vài tuần tới.
Công cụ phát hiện hạn chế: detector chưa mở công khai. Hiện chỉ nhà nghiên cứu và tổ chức chuyên môn được duyệt mới được nộp đơn, xét từng trường hợp theo Bộ quy tắc thực hành (Code of Practice) của EU.
Với ảnh và âm thanh thì không đổi: công cụ openai.com/verify và Content Provenance API vẫn mở công khai để kiểm tra một file có phải do model của OpenAI tạo ra hay không.
textGrain hoạt động như thế nào?
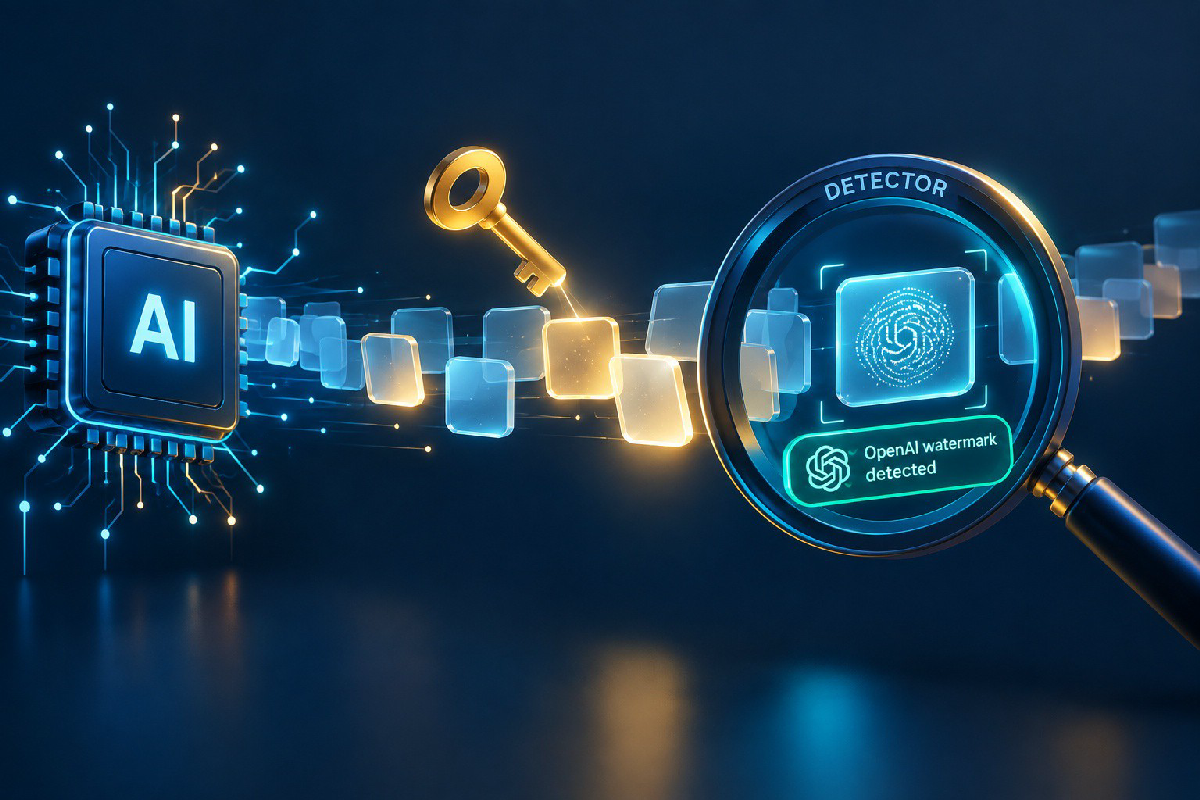
Đừng hình dung một logo mờ hay ký tự ẩn chèn vào văn bản. textGrain cài một tín hiệu thống kê vào chính cách model chọn từ. Mỗi khi model chọn từ tiếp theo, một khóa bí mật "nghiêng" lựa chọn đó đi một chút. Một lần thì không ai nhận ra, nhưng cộng hàng trăm lần lại thì detector có đủ bằng chứng thống kê.
Báo cáo kỹ thuật đi kèm, viết chung với các nhà nghiên cứu của Đại học Pennsylvania và Yale, mô tả phương pháp ghép việc sinh token với nguồn ngẫu nhiên có khóa thông qua bài toán vận chuyển tối ưu (optimal transport), dùng chi phí dựa trên biến ngẫu nhiên Gumbel và điều chuẩn KL. Điểm đáng chú ý: detector chỉ cần văn bản và khóa bí mật, không cần biết model nào đã viết hay dùng mức "ngân sách" thủy vân bao nhiêu.
Vì tín hiệu nằm trong chữ chứ không nằm trong metadata, nó đi theo văn bản khi bạn copy sang chỗ khác. OpenAI nói textGrain "ngang bằng hoặc vượt" các cách khác mà họ thử, trong đó có SynthID for text của Google DeepMind, và dự định mở mã nguồn công nghệ này.
Thủy vân có dễ bị xóa không?
Có, và OpenAI tự đưa số liệu ra. Ở ngưỡng báo nhầm (false positive) mục tiêu 1%, với nội dung kiểu tâm lý học:
Đoạn 400 token (khoảng 300 từ tiếng Anh): phát hiện được khoảng 95%.
Đoạn 200 token: còn khoảng 80%.
Nội dung toán học: thấp hơn đáng kể, vì đề toán ít chỗ để thay đổi cách dùng từ.
Sửa văn bản còn làm tín hiệu yếu nhanh hơn. Trong thử nghiệm với đoạn 400 token, thay 10% số từ bằng từ đồng nghĩa làm tỷ lệ phát hiện giảm từ khoảng 92% xuống 66%. Thay 25% thì chỉ còn 17%. Đoạn ngắn, bài toán và văn bản đã dịch sang ngôn ngữ khác cũng khó phát hiện hơn.
Chính vì vậy OpenAI chỉ cho nhóm nghiên cứu được duyệt dùng detector: một công cụ có thể báo nhầm hoặc bỏ sót, nếu mở cho đại trà, rất dễ bị dùng để "kết tội" ai đó dùng AI.
Có làm ChatGPT kém thông minh đi không?
Theo OpenAI thì gần như không. Hãng chạy bộ benchmark của Astra, model frontier mới nhất, ở chế độ max, có và không có thủy vân. Một vài kết quả:
Artificial Analysis Intelligence Index: 49,57 điểm (không thủy vân) và 49,76 điểm (có thủy vân).
GPQA Diamond: 94,44% và 93,94%.
DeepSWE v1.1: 72,80% và 71,68%.
Terminal-Bench 4.0: 53,90% và 56,06%.
BrowseComp: 87,92% và 87,35%.
Chênh lệch lên xuống vài phần trăm theo cả hai chiều, nên khó nói thủy vân làm model tệ đi. Tuy vậy, như The Decoder lưu ý, benchmark đo khả năng giải bài chứ chưa trả lời được câu hỏi văn phong có bị ảnh hưởng hay không.
Thủy vân KHÔNG nói lên điều gì?
Đây là phần OpenAI nhấn mạnh nhiều nhất. Một kết quả phát hiện chỉ cho biết hệ thống của OpenAI đã tạo ra hoặc xử lý một phần đoạn văn. Nó không cho biết:
Người viết đã đóng góp, chỉnh sửa hay sáng tạo bao nhiêu.
Ai sở hữu văn bản, ai chịu trách nhiệm, việc sử dụng có hợp pháp hay không.
Ai là người dùng: thủy vân không gắn với tài khoản, prompt hay cuộc trò chuyện nào.
Nội dung đúng hay sai.
Ngược lại, không thấy thủy vân cũng không chứng minh người thật viết. Văn bản có thể quá ngắn, đã sửa, đã dịch, sinh ra trước khi có thủy vân, từ model không được hỗ trợ, hoặc từ AI của hãng khác.
Vì sao lại là EU, và Anthropic làm gì?
Các quy định minh bạch tại Điều 50 của EU AI Act có hiệu lực từ 2/8/2026, yêu cầu nhà cung cấp AI tạo sinh làm cho nội dung do AI tạo ra có thể nhận diện bằng máy. Bộ quy tắc thực hành về minh bạch nội dung do AI tạo (bản cuối công bố ngày 10/6/2026) là con đường tự nguyện để chứng minh tuân thủ. Theo Search Engine Journal, đến cuối tháng 7 đã có khoảng 190 tổ chức ký; Anthropic, Google, Meta, Microsoft và OpenAI đều nằm trong số cam kết.
Anthropic đi trước khoảng hai tháng: từ tháng 8, hãng gắn thủy vân cho văn bản Claude trên toàn cầu, dựa trên công nghệ SynthID mã nguồn mở của Google. Quyết định đó từng bị một số người dùng Claude phản đối, vì họ cho rằng chính họ đưa ra "chỉ dẫn, bối cảnh, quyết định", còn Claude chỉ là công cụ. OpenAI chọn cách mềm hơn: chỉ bật mặc định ở EU, còn API thì để khách hàng tự chọn.
Đây cũng là một bước ngoặt nhỏ với chính OpenAI. Năm 2024, Wall Street Journal từng đưa tin hãng đã làm xong công cụ thủy vân văn bản nhưng chưa tung ra, một phần vì lo người dùng chuyển sang đối thủ không gắn thủy vân.
Người dùng Việt Nam có bị ảnh hưởng không?
Trước mắt thì gần như không. Thủy vân trên ChatGPT và Codex chỉ áp dụng cho người dùng ở EU, còn API mặc định tắt. Nhưng có vài điều nên để ý:
Nếu bạn dùng một app, website hay dịch vụ xây trên API OpenAI, chính nhà phát triển có thể bật thủy vân mà bạn không biết.
Nếu bạn làm việc với đối tác hoặc khách hàng ở EU, văn bản họ gửi bạn, hoặc bạn soạn bằng tài khoản của họ, có thể đã mang thủy vân.
Đừng tin vào các web "check AI" tự xưng đọc được textGrain: detector chính thức hiện chưa mở công khai.
Về lâu dài, textGrain cho thấy xu hướng rõ ràng: luật châu Âu đang buộc các ông lớn AI phải để lại "dấu vân tay" trên những gì máy viết. Nhưng chính OpenAI cũng thừa nhận, với chữ thì dấu vân tay ấy vẫn rất dễ phai.
Nguồn tham khảo
- OpenAI - Our approach to EU text provenance rules: https://openai.com/index/eu-text-provenance/
- OpenAI - textGrain technical report: https://cdn.openai.com/pdf/e9508624-d767-41b6-a26d-e34ca798ada6/textgrain-entropy-calibrated-watermarking-for-language-model-text.pdf
- TechCrunch - OpenAI will start watermarking ChatGPT's text in the EU: https://techcrunch.com/2026/10/05/openai-will-start-watermarking-chatgpts-text-in-the-eu/
- The Verge - OpenAI is adding text watermarking in ChatGPT and Codex: https://www.theverge.com/ai-artificial-intelligence/1004880/openai-chatgpt-text-watermarks-eu-ai-act
- The Decoder - OpenAI will watermark ChatGPT text in the EU: https://the-decoder.com/openai-will-watermark-chatgpt-text-in-the-eu-but-makes-it-optional-for-api-users-worldwide/
- Search Engine Journal - OpenAI To Watermark ChatGPT Text In The EU: https://www.searchenginejournal.com/openai-to-watermark-chatgpt-text-in-the-eu-opens-api-opt-in/592014/
- Unite.AI - OpenAI Begins Phased Text Watermarking Under EU AI Act Rules: https://www.unite.ai/openai-begins-phased-text-watermarking-under-eu-ai-act-rules/
Nội dung bị khóa
Tác giả đã khóa nội dung này. Hãy mở khóa để xem tiếp.
Đánh giá 1-5 sao để mở khóa:
Bài viết liên quan
→ Xem tất cả
Super Intelligence Force: Trump giao Jay Clayton làm 'AI czar'
31 min read
OpenAI: lãnh đạo an toàn David Robinson từ chức vì văn hóa 'hỏng'
21 min read
Meta Muse Gadgets: open-source SDK và 5000 Home Link
14 min read
Thảo luận
0 ý kiếnĐăng nhập để tham gia thảo luận cùng cộng đồng ctdohub.
Đăng nhập →Chưa có ý kiến
Hãy là người đầu tiên chia sẻ góc nhìn của bạn.