Kimi K3.1 Pro: model mở 3T tham số áp sát Claude Opus 5.5, giá 2 USD
Moonshot AI vừa tung Kimi K3.1 Pro, model đầu tiên của dòng K3.1 và cũng là model mở (open-weight) mạnh nhất từ trước tới nay của startup Trung Quốc này. Model thuộc lớp 3 nghìn tỷ tham số, có ngữ cảnh 1 triệu token, áp sát Claude Opus 5.5 ở bài test lập trình và chỉ có giá 2 USD cho 1 triệu token đầu vào.
Điểm đáng chú ý không chỉ là sức mạnh. Moonshot nói đã chủ động cắt bớt khả năng hack của bản open-weight trước khi phát hành, một bước khá hiếm ở các lab làm model mở.
Kimi K3.1 Pro là gì?
Kimi K3.1 Pro được Moonshot công bố hôm thứ Sáu 23/10/2026. Đây là bản post-train của Kimi K3, model gần 3 nghìn tỷ tham số mà Moonshot đã mở trọng số hồi tháng 7, nhưng được huấn luyện tăng cường (RL) thêm với lượng compute lớn hơn nhiều.
Quy mô: lớp 3T tham số. Theo Artificial Analysis, model có 2,8 nghìn tỷ tham số tổng và 104 tỷ tham số hoạt động mỗi lượt.
Ngữ cảnh: 1.048.576 token, nhận đầu vào chữ và ảnh.
Bản Highspeed: Kimi K3.1 Pro Highspeed có cùng trí tuệ nhưng chạy nhanh gấp 2-3 lần bản thường.
Có ở đâu: kimi.ai, app Kimi (iOS, Android, HarmonyOS), Kimi Work, Kimi Code và Kimi API.
Trọng số đầy đủ: Moonshot hẹn công bố chậm nhất ngày 4/11/2026.
Điểm benchmark: áp sát Claude Opus 5.5
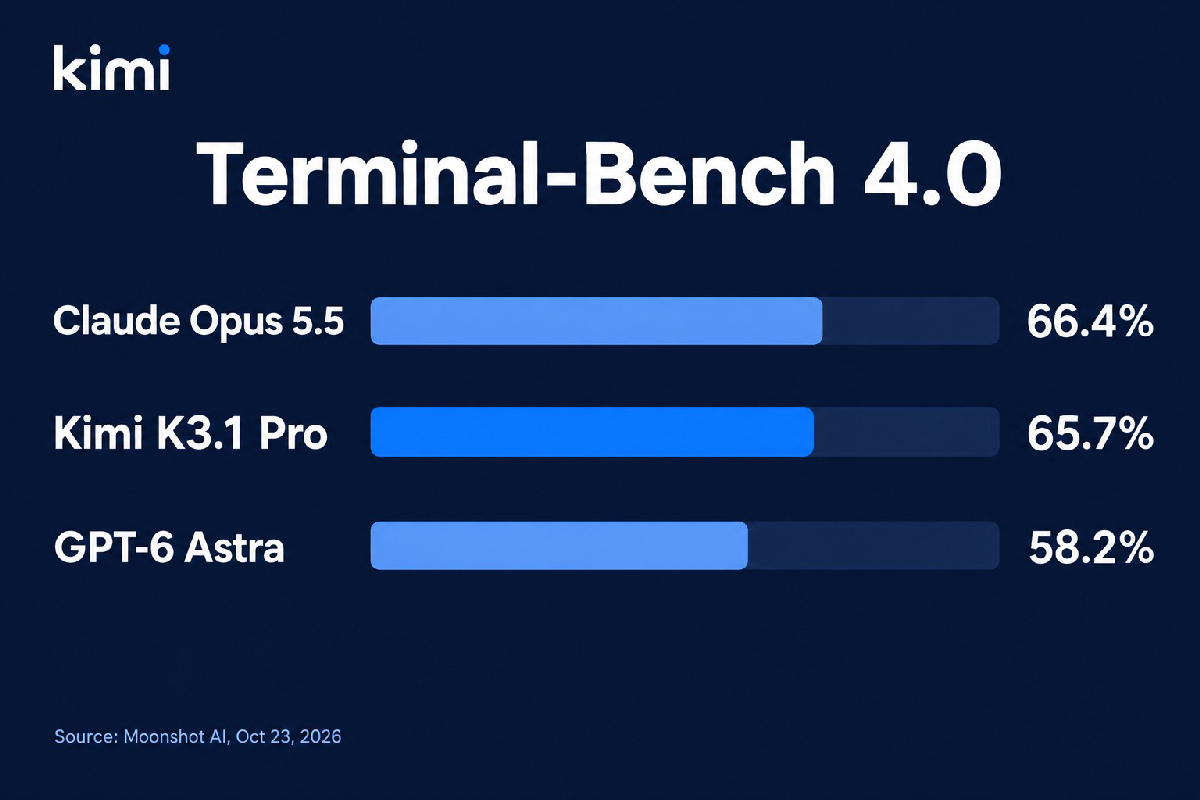
Bài test được Moonshot nhấn mạnh nhất là Terminal-Bench 4.0, đo khả năng của agent lập trình trên các tác vụ terminal thật. K3.1 Pro đạt 65,7%, vượt GPT-6 Astra (58,2%) và chỉ kém Claude Opus 5.5 (66,4%) chưa tới 1 điểm. Trong bài đo độc lập của Artificial Analysis, K3.1 Pro còn đạt 67% trên Terminal-Bench 4.0, cao nhất trong mọi model hãng này đã test.
Artificial Analysis Intelligence Index: 55 điểm, hạng 4, chỉ sau Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) và Muse Wonder Full (56). Mức này cao hơn Kimi K3 tới 11 điểm.
GDPval-AA (tác vụ công việc thực tế): 1.846 Elo, hạng 3, tăng 312 Elo so với K3.
BenchCAD (dựng mô hình 3D bằng code CAD, có dùng tool): 92,7%, so với 96,2% của Opus 5.5 và 95,9% của GPT-6 Astra.
Ảo giác: trên bài stress test nội bộ Kimi Hallu Bench Hard, tỷ lệ nhận định sai giảm từ 23,4% ở K3 xuống 8,3%.
Theo Artificial Analysis, khi trọng số được công bố, K3.1 Pro sẽ thành model mở điểm cao nhất từng có, và khoảng cách giữa model mở dẫn đầu với model đóng tốt nhất trên Intelligence Index sẽ thu hẹp từ 12 điểm xuống còn 3. Lưu ý là phần lớn con số trên do Moonshot tự công bố, chưa được kiểm chứng độc lập hết.
Giá API rẻ hơn Kimi K3 tới 33%
Kimi K3.1 Pro tính giá phẳng trên toàn bộ cửa sổ 1 triệu token, không chia bậc theo độ dài ngữ cảnh:
kimi-k3.1-pro: 2 USD/1 triệu token vào, 10 USD/1 triệu token ra, 0,20 USD/1 triệu token cache.
kimi-k3.1-pro-highspeed: 4 USD vào, 20 USD ra, 0,20 USD cache.
Mức giá này thấp hơn Kimi K3 khoảng 33% ở cả ba hạng mục. Artificial Analysis tính ra chi phí trung bình khoảng 1,98 USD mỗi tác vụ trong bộ Intelligence Index, gần bằng K3 dù model dùng nhiều token hơn. Để dùng qua API, bạn cần nạp tối thiểu 1 USD; tham số reasoning_effort có 3 mức low, high và max (mặc định max), chế độ suy luận luôn bật.
Moonshot chủ động "giảm khả năng hack"
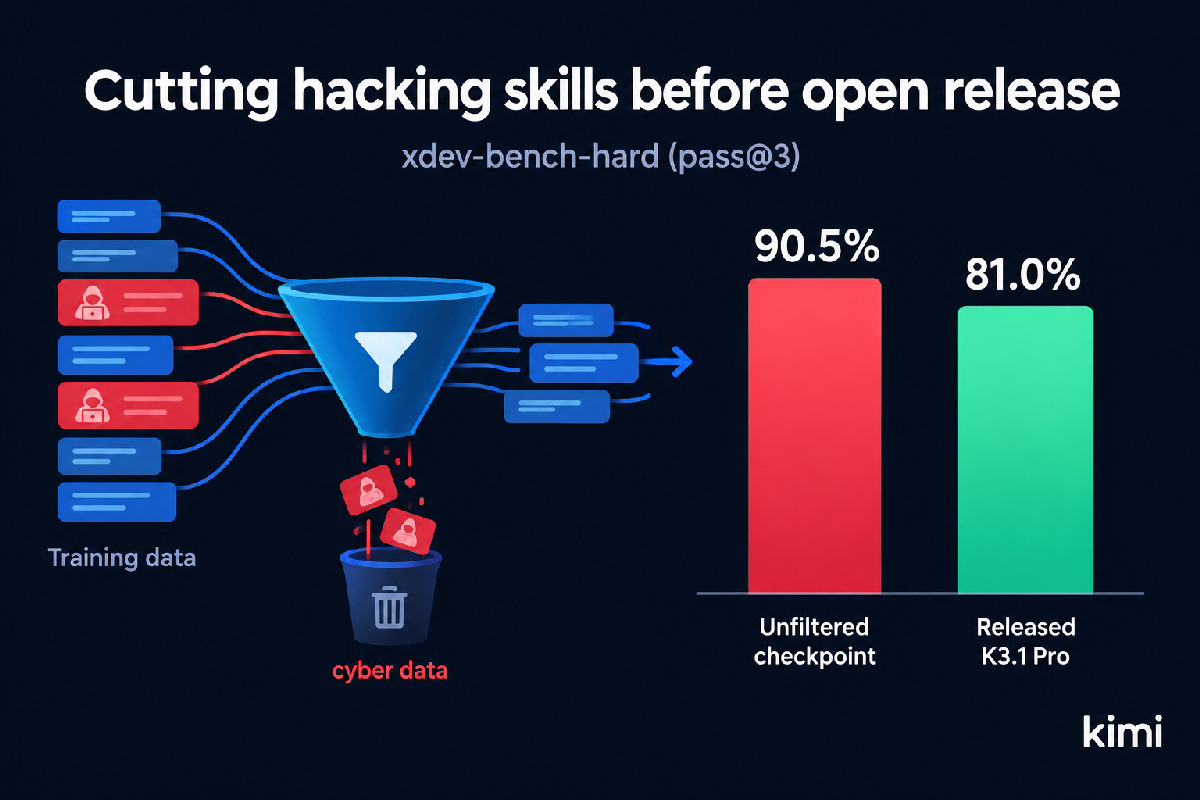
Đây là phần khiến K3.1 Pro được chú ý nhiều trên báo quốc tế. Moonshot phát hiện năng lực tìm và khai thác lỗ hổng tăng đều khi tăng huấn luyện, do dữ liệu bảo mật nằm lẫn trong kho dữ liệu chung và môi trường RL. Với bản open-weight, hãng đã lọc bỏ dữ liệu liên quan tấn công mạng ở cả giai đoạn mid-training lẫn RL, nhưng giữ lại các tác vụ lập trình thông thường.
Kết quả trên bài test nội bộ xdev-bench-hard (khai thác lỗ hổng thật trong Linux kernel, Node.js, JavaScriptCore...): checkpoint không lọc giải được 90,5%, còn bản K3.1 Pro phát hành đạt 81,0%. Con số vẫn cao hơn nhiều so với 33,3% của K3, và Moonshot thừa nhận model vẫn đứng sau các model đóng hàng đầu. Hãng tuyên bố nguyên tắc: không phát hành model mở nào đẩy xa giới hạn năng lực tấn công mạng hiện có.
Bối cảnh là nỗi lo AI giúp hack dễ hơn đang tăng mạnh. Tuần trước Trung Quốc vừa đề xuất kiểm soát xuất khẩu công nghệ tạo mã độc bằng AI và công cụ AI tìm lỗ hổng. Một khi trọng số được tải về, nhà phát triển gần như không thể thu hồi hay giám sát cách người khác dùng model.
Có đáng để dùng thử?
Nếu bạn làm lập trình, agent hoặc phân tích tài chính và muốn một model gần ngang hàng đầu với giá mềm, Kimi K3.1 Pro rất đáng thử, nhất là khi có thể tự chạy trên hạ tầng riêng sau ngày 4/11. Với dân dùng thường, cách nhanh nhất là vào kimi.ai hoặc cập nhật app Kimi. Còn với ngành AI, K3.1 Pro là tín hiệu rõ: khoảng cách giữa model mở và model đóng đang rút ngắn rất nhanh, kéo theo cả câu hỏi về an toàn khi những model mạnh như vậy được phát tán tự do.
Nguồn
Nội dung bị khóa
Tác giả đã khóa nội dung này. Hãy mở khóa để xem tiếp.
Đánh giá 1-5 sao để mở khóa:
Bài viết liên quan
→ Xem tất cả
iPhone Duo: giá tại Việt Nam, thông số và có nên mua?
58 min read
OpenAI cắt Internet khi huấn luyện AI sau loạt sự cố model vượt rào
29 min read
Lỗ hổng PHP2Shell: AI tìm ra lỗi PHP nghiêm trọng, cần vá ngay
31 min read
Thảo luận
0 ý kiếnĐăng nhập để tham gia thảo luận cùng cộng đồng ctdohub.
Đăng nhập →Chưa có ý kiến
Hãy là người đầu tiên chia sẻ góc nhìn của bạn.